1. TF-IDF + Logistic Regression
Baseline One-vs-Rest, n-grams (1,2), max_features 50k et seuil de décision à 0,5.
NLP · SemEval 2018 Task E-c · Classification multi-label
Un projet expérimental qui combine modélisation, comparaison de baselines, calibration de seuils et intégration d'un modèle spécialisé dans un démonstrateur LLM local.
Tâche
Le projet s'appuie sur le dataset anglais de SemEval 2018 Task E-c. Chaque tweet peut recevoir zéro, une ou plusieurs émotions parmi : anger, anticipation, disgust, fear, joy, love, optimism, pessimism, sadness, surprise et trust.
Les jeux de données contiennent 6 838 exemples d'entraînement, 886 exemples de développement et 3 259 exemples de test.
Approche
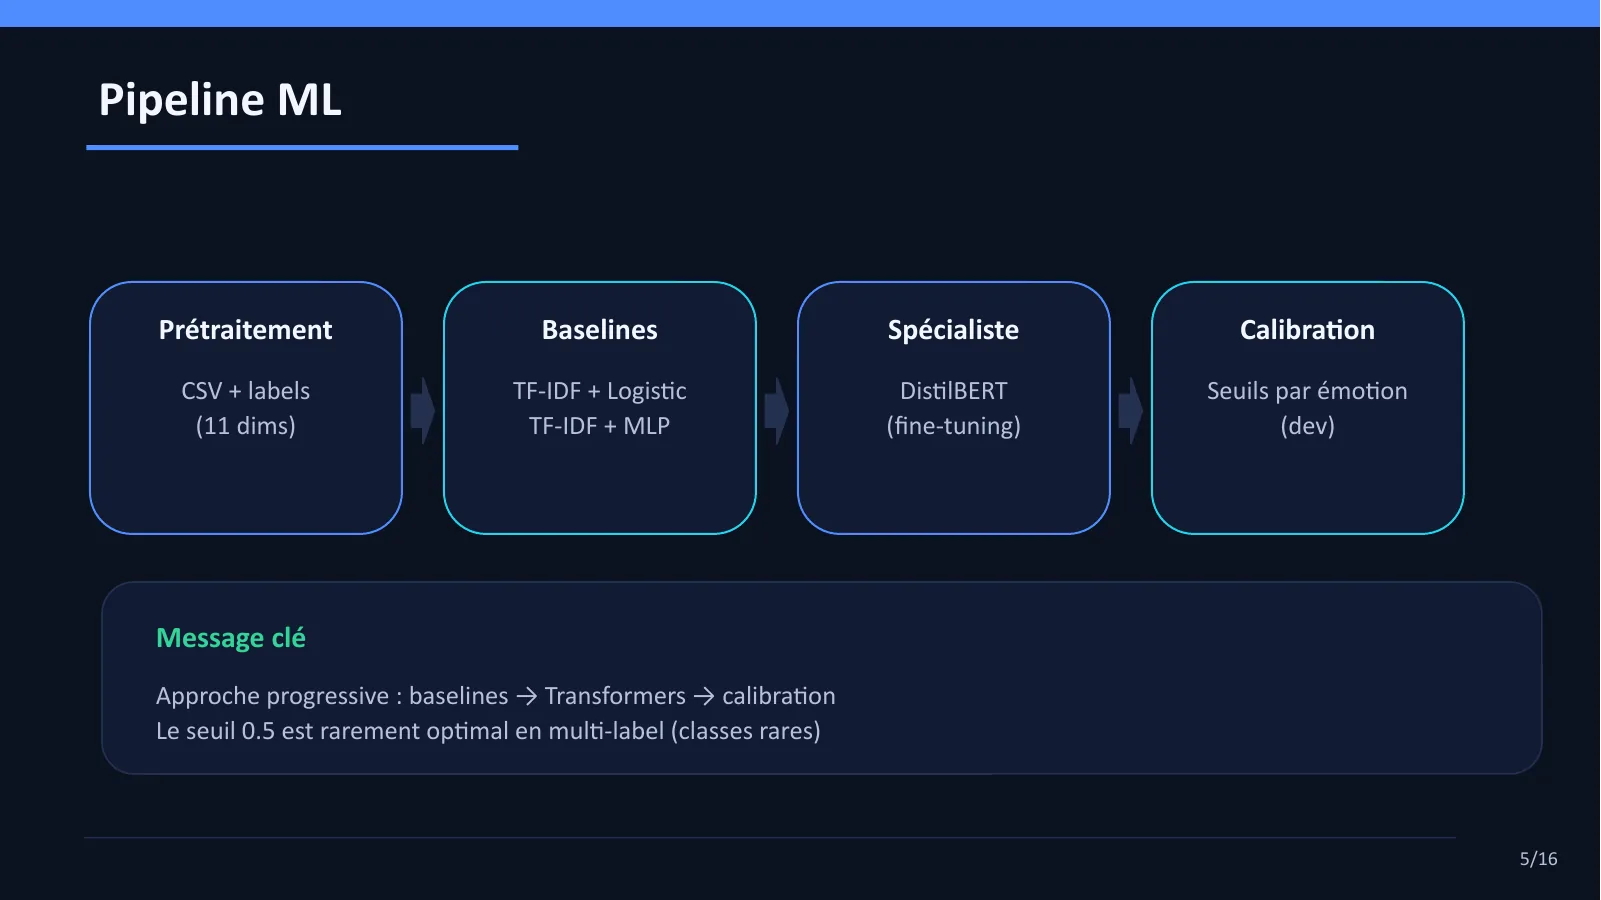
Baseline One-vs-Rest, n-grams (1,2), max_features 50k et seuil de décision à 0,5.
Réseau avec une couche cachée de 256 unités, optimisé pour la classification multi-label.
distilbert-base-uncased, 11 sorties sigmoïdes, entraînement sur trois epochs et perte BCEWithLogitsLoss.
Recherche de seuils entre 0,1 et 0,9 sur le jeu de développement afin d'améliorer le macro-F1, notamment pour les classes rares.
Évaluation
| Approche | Macro-F1 | Micro-F1 |
|---|---|---|
| TF-IDF + Logistic Regression | 0,313 | 0,467 |
| MLP + TF-IDF | ≈ 0,381 | ≈ 0,547 |
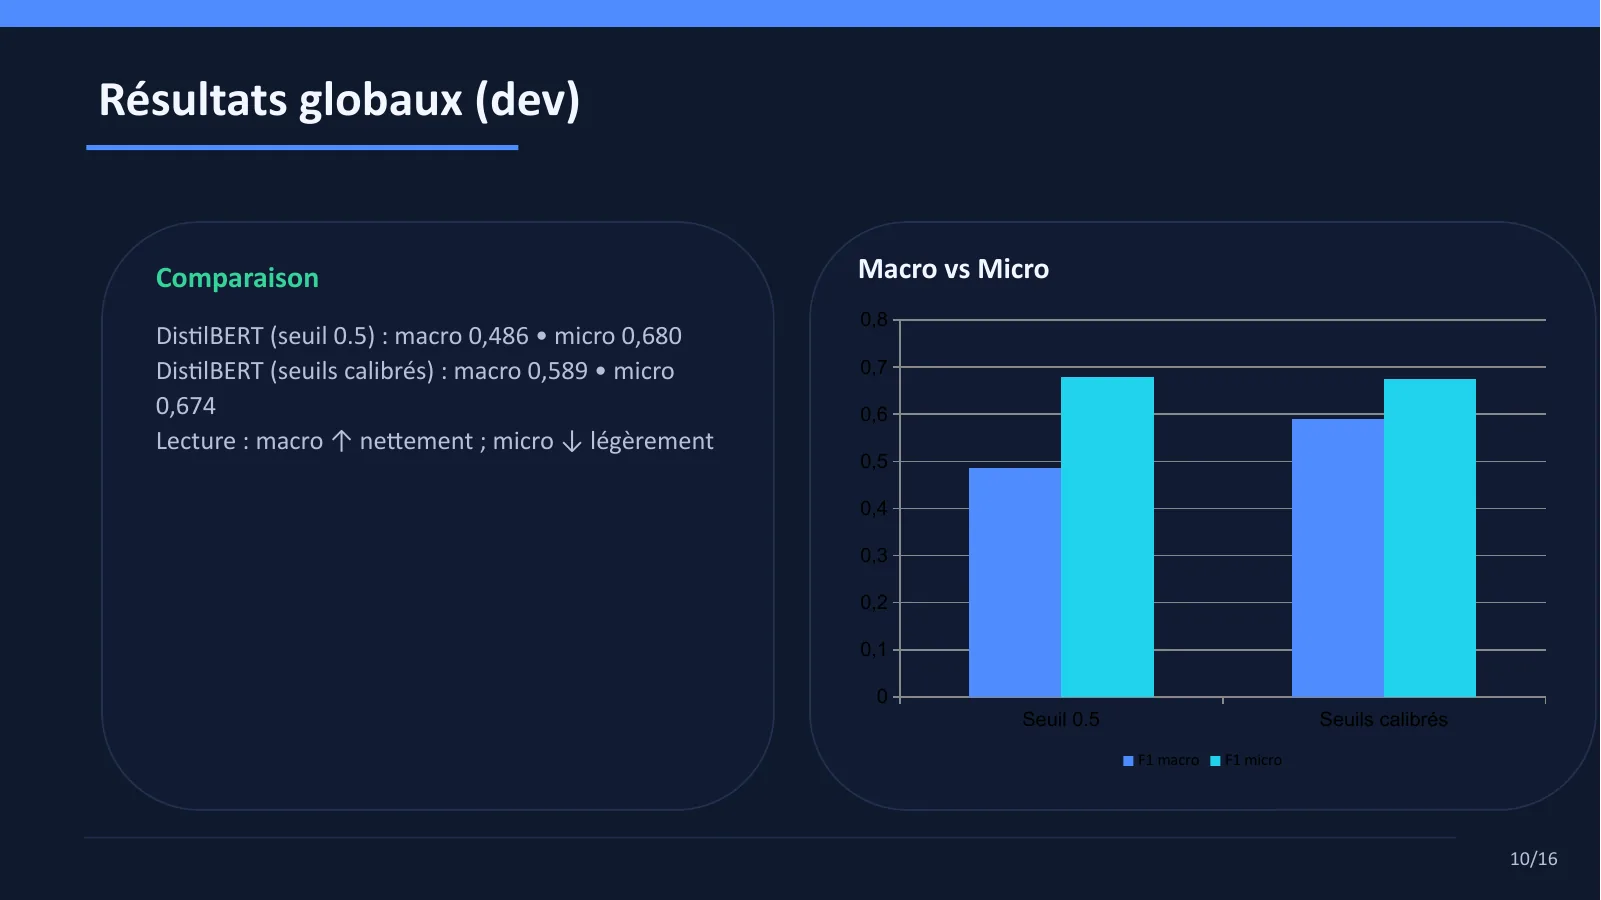
| DistilBERT — seuil 0,5 | 0,486 | 0,680 |
| DistilBERT — seuils calibrés | 0,589 | 0,674 |
La calibration améliore nettement le macro-F1, de 0,486 à 0,589, au prix d'une légère baisse du micro-F1, de 0,680 à 0,674.
Recul critique
trust : F1 ≈ 0,20
surprise : F1 ≈ 0,27
Leur support plus faible et leur ambiguïté les rendent particulièrement difficiles.
Classes rares, tweets courts, contexte implicite, ironie et dépendance à un dataset anglais. L'usage en français n'est donc pas natif.
Intégration
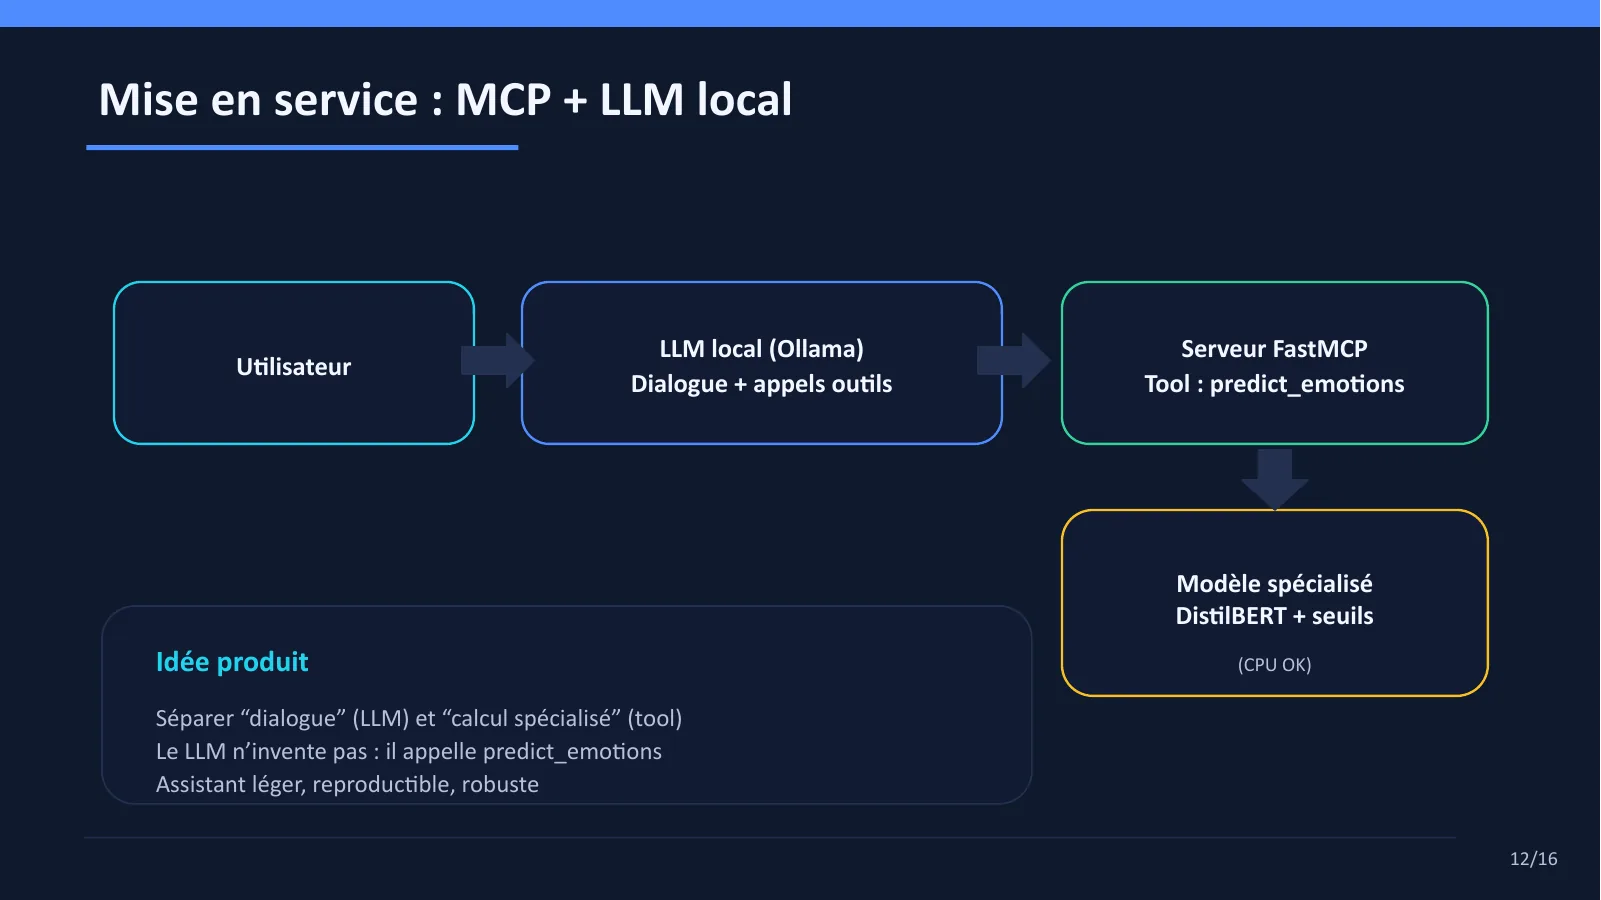
Le projet inclut un démonstrateur expérimental dans lequel un LLM local via Ollama gère le dialogue et délègue la classification à un outil spécialisé predict_emotions exposé par un serveur FastMCP.
Le tool renvoie notamment les scores par émotion, les labels activés selon les seuils calibrés et un top-k des probabilités. Cette séparation permet de garder le dialogue côté LLM tout en confiant le calcul de classification au modèle spécialisé.